Сообщение «сайт недоступен» может означать разные ситуации: не работает интернет у пользователя, ошибается DNS, истёк сертификат, недоступно приложение или перегружена база. Если компания смешивает эти причины, она тратит время на бессистемные перезапуски. Полезный мониторинг должен показывать, какой участок цепочки перестал работать и насколько это влияет на пользователей.
Рассмотрим условный информационный сервис с публичным сайтом, редакторской панелью и внутренней базой. Здесь важны не громкие обещания бесперебойности, а наблюдения из нескольких точек, история событий и проверяемое восстановление. Технические показатели не нужно выдавать за статистику конкретного СМИ.
Одна проверка не видит всю систему
Локальный мониторинг видит процесс, память и накопители. Внешняя проверка показывает доступность со стороны сети пользователя. Они дополняют друг друга. Если сервер отвечает внутри площадки, это не доказывает, что публичный адрес доступен извне и посетитель получает нужную страницу.
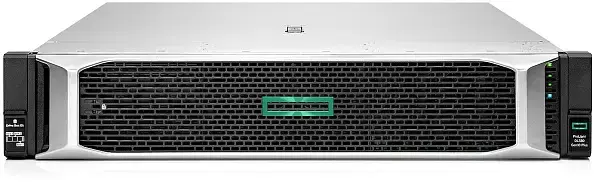
Для локальных сервисов наблюдения и обработки данных можно рассмотреть HPE ProLiant DL380 Gen10. Варианты комплектации доступны у Сервер Молл: https://servermall.ru/sets/server-hpe-proliant-dl380-gen10/. Однако единственную проверку нельзя размещать только на том узле, который она контролирует: при его отказе одновременно исчезнут приложение и наблюдение.
Минимальная схема включает внутренние метрики, внешнюю проверку публичного адреса и отдельный канал уведомления ответственного. Где физически находятся эти компоненты, зависит от проекта. Важно, чтобы отказ основной системы не лишал компанию всех способов узнать об аварии.
Проверять последовательно: от имени до результата
Первый уровень — разрешение доменного имени. Нужно знать, какой адрес вернулся и сколько занял ответ. Второй — соединение с нужным портом. Третий — защищённое соединение и срок сертификата. Четвёртый — ответ приложения. Пятый — содержание ответа и выполнение значимого действия.
HTTP-ответ с кодом 200 сам по себе не доказывает исправность бизнеса. Вместо новостей приложение может вернуть пустую страницу, сообщение об ошибке или старую копию. Проверка должна искать ожидаемый признак, а для важных функций — выполнять безопасный синтетический сценарий.
Например, для публичного сайта можно проверять получение тестовой страницы с известным идентификатором. Для панели редактора — вход специально созданной записи без административных полномочий. Если сценарий создаёт объект, он должен использовать отдельные тестовые данные и не отправлять настоящие уведомления.
Как задавать частоту и пороги
Предположим, внешняя проверка запускается раз в минуту, а тревога возникает после трёх последовательных неудач. Обнаружение займёт примерно две–три минуты плюс время выполнения проверок и отправки сообщения. Такой режим уменьшает реакцию на единичный сбой, но не подходит там, где требуется заметить остановку за несколько секунд.
При проверке раз в пять минут тот же принцип может дать около десяти–пятнадцати минут задержки. Поэтому интервал и число повторов выбирают исходя из допустимого времени обнаружения. Фраза «мониторинг установлен» ничего не говорит о том, когда ответственный фактически получит сигнал.
Порог задержки также устанавливают по сценарию. Если обычная страница открывается за 300 миллисекунд, рост до пяти секунд заслуживает внимания даже без полного отказа. Для тяжёлого отчёта пять секунд могут быть нормой. Один порог для всех адресов создаёт либо шум, либо пропуск проблемы.
Доступность нужно считать с оговорками
В расчётном 30-дневном периоде 43 200 минут. Если недоступность составила 60 минут, доля доступного времени по такой методике равна (43 200 − 60) / 43 200, или примерно 99,861%. Это арифметика условного примера, а не измерение какого-либо сервиса.
Для честного отчёта нужно определить, что считается отказом, как учитываются плановые работы и что происходит при потере самого мониторинга. Отсутствие измерений нельзя автоматически записывать в успешную работу. Иначе отключённый наблюдатель неожиданно улучшит показатель доступности.
Отчёт из одной точки описывает опыт этой точки. Если часть пользователей не может открыть сайт из другой сети, локальная проверка этого не заметит. Для критичного сервиса используют несколько независимых направлений и отдельно показывают общую аварию и проблемы отдельного маршрута.
Как не утонуть в уведомлениях
При отказе базы могут одновременно появиться десятки сигналов от приложений. Если отправить каждый отдельно, ответственный получит поток сообщений без понимания первопричины. Зависимости полезно учитывать: одна понятная тревога о базе и список затронутых функций лучше повторяющегося шума.
У каждого сигнала должен быть владелец, степень влияния и первое действие. Например: «публичная страница недоступна из двух точек, внутренний API отвечает; проверить внешний маршрут и прокси». Это полезнее сообщения «ошибка сервера», которое не объясняет ни масштаб, ни направление диагностики.
Для обслуживания предусмотрен режим согласованных работ. Он не должен бесследно удалять историю: полезно видеть, что перерыв был запланирован. После окончания окна проверки возвращаются автоматически или по контролируемой процедуре, иначе сервис может остаться без наблюдения.
Маршрут эскалации проверяют отдельно: кто получает первый сигнал, через сколько времени подключается второй ответственный и кто сообщает пользователям о длительном перерыве. Если уведомление пришло в общий чат, но никто не обязан принять его в работу, система обнаружения формально исправна, а реагирование всё равно не организовано.
Какие метрики помогают найти причину
На стороне приложения нужны число запросов, доля ошибок и время ответа. Для базы — активные соединения, задержки запросов и состояние хранения. На сервере — доступная память, загрузка процессора, свободное место и дисковые задержки. Одного графика CPU недостаточно, чтобы объяснить все варианты недоступности.
Высокая занятость памяти не всегда означает нехватку, поскольку часть её может использоваться для кеширования. И наоборот, умеренная загрузка процессора не исключает ожидания диска или внешнего сервиса. Метрики сопоставляют с пользовательской задержкой и журналами, а не оценивают каждую по отдельности.
Для событий нужны согласованные часы и явный часовой пояс. Тогда запись об ошибке можно сопоставить с изменением конфигурации и сигналом внешней проверки. Если системы показывают разное время, расследование становится поиском похожих строк вместо восстановления точной последовательности.
Как проверить сам мониторинг
- Контролируемо остановить тестовый сервис и измерить время до уведомления.
- Вернуть сервис и проверить сообщение о восстановлении.
- Смоделировать ошибку содержимого при успешном HTTP-ответе.
- Проверить резервный канал связи с ответственным.
- Убедиться, что отказ наблюдателя также становится заметным.
Испытания проводят в согласованное время и не заменяют случайным отключением рабочей системы. Для каждого сценария фиксируют начало, момент обнаружения, получение уведомления и восстановление. Это позволяет проверить всю цепочку, включая доставку сообщения человеку.
Наконец, мониторинг не восстанавливает сервис сам по себе. Нужны инструкции, резервные копии и ответственные за действия. Его ценность в другом: компания перестаёт узнавать о проблемах исключительно от посетителей и получает факты для диагностики вместо предположений о том, «у кого не работает интернет».
После аварии сохраняют короткую хронологию: начало влияния, первый сигнал, подтверждение причины и возврат функций. Время обнаружения отделяют от времени ремонта. Это позволяет понять, что нужно улучшить в следующий раз: наблюдение, доставку тревоги, диагностику или процедуру восстановления.